Skills
学习笔记
Skill
理解 Agent Skills 的核心定位:把可复用提示词、流程、资源和脚本封装成能力包。
1.为什么需要 Skills
Skills 的价值,就是把这些反复使用的经验整理成可复用、可发现、可按需加载的能力包。
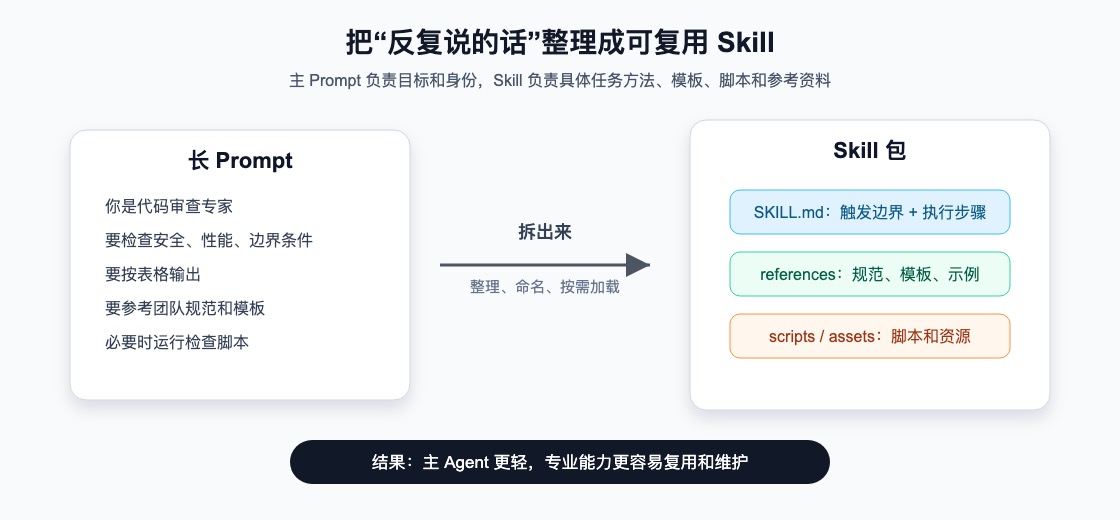
先记住一个简化公式:Skill = 可复用提示词 + 专业流程 + 可选脚本 + 可选资源
三个关键词
| 关键词 | 含义 | 例子 |
|---|---|---|
| 可复用 | 一套能力可以给多个任务使用 | 代码审查标准、报告模板、测试修复流程 |
| 可发现 | Agent 能先看到技能名和描述 | 通过 name 和 description 判断要不要用 |
| 按需加载 | 不用一开始把全部内容塞进上下文 | 任务匹配后再读完整 SKILL.md、模板、脚本和资源 |
2.Skill 到底是什么
Skill 可以理解为 Agent 的外置能力包,通常把高质量提示词、任务步骤、触发条件、输出规范,以及可选脚本、依赖、模板、示例和参考资料放在一起。
把这些内容打包后,Agent 就可以在合适场景下加载并使用这项能力。
工程本质
从工程角度看,Skill 的核心并不复杂:
Skill = 可复用提示词 + SOP + 可选脚本 + 可选资源
例如你写了一个“代码审查技能”,里面可以说明:
- 什么情况下触发代码审查;
- 审查哪些维度;
- 哪些问题必须重点标出;
- 输出什么格式;
- 如果需要运行脚本,脚本放在哪里;
- 如果没有发现问题,应该怎么表达剩余风险。
以后其他 Agent 想具备这项能力,就不用重新手写提示词,只要把这个 Skill 配进去。
它和普通复制粘贴提示词的区别在于:Skill 有固定目录结构和元数据,可以被支持 Skills 的工具或框架识别,并按需加载到上下文中。
3.SKILL.md 目录结构
3.1 最小目录结构
一个标准 Skill 通常是一个文件夹,里面至少包含一个 SKILL.md 文件。
示意结构:
skills/
  emoji-translator/
    SKILL.md
其中:
skills/是技能目录;emoji-translator/是某个具体技能包;SKILL.md是这个技能包的说明文件。
SKILL.md 通常分成两部分:
- YAML Frontmatter:给模型或框架看的元数据。
- Markdown 正文:给 Agent 执行任务时看的详细说明。
一个最小示例:
---
name: emoji-translator
description: 当用户明确要求把自然语言翻译成 Emoji、把 Emoji 解释成文字,或要求“表情翻译/emoji 翻译”时使用。
---

# Emoji Translator Skill

## 角色定位

你是一个表情翻译助手,负责在自然语言和 Emoji 之间转换。

## 触发边界

- 用户明确要求“用表情翻译”“转换成 Emoji”“解释这些 Emoji”时,使用本技能。
- 用户只是普通聊天、提问或写作时,不要主动把内容转成 Emoji。
- 如果用户要求“只用表情”,最终输出只包含 Emoji,不额外解释。
3.2 元数据字段
元数据里最重要的是两个字段:
| 字段 | 作用 | 建议 |
|---|---|---|
name |
技能唯一名称,通常和技能文件夹名保持一致 | 使用小写字母、数字和短横线,避免空格和中文名 |
description |
告诉模型这个技能什么时候应该被使用 | 写清楚“做什么”和“什么时候用” |
因为模型通常会先看 name 和 description,再决定是否加载完整 Skill。如果描述太模糊,Skill 就可能触发不了;如果描述太宽泛,又可能在不该触发时被错误触发。
3.3 常见扩展字段
常见扩展字段包括:
| 字段 | 常见用途 |
|---|---|
license |
标记 Skill 的许可证 |
compatibility |
说明依赖环境、网络访问、运行时限制 |
metadata |
放作者、版本、团队、维护信息 |
allowed-tools |
限制 Skill 激活后可用的工具,部分平台支持 |
module |
指向可导入模块或辅助代码,部分 Agent Skills 实现支持 |
3.4 扩展目录结构
复杂 Skill 不一定只有 SKILL.md,还可以带脚本、依赖和资源。
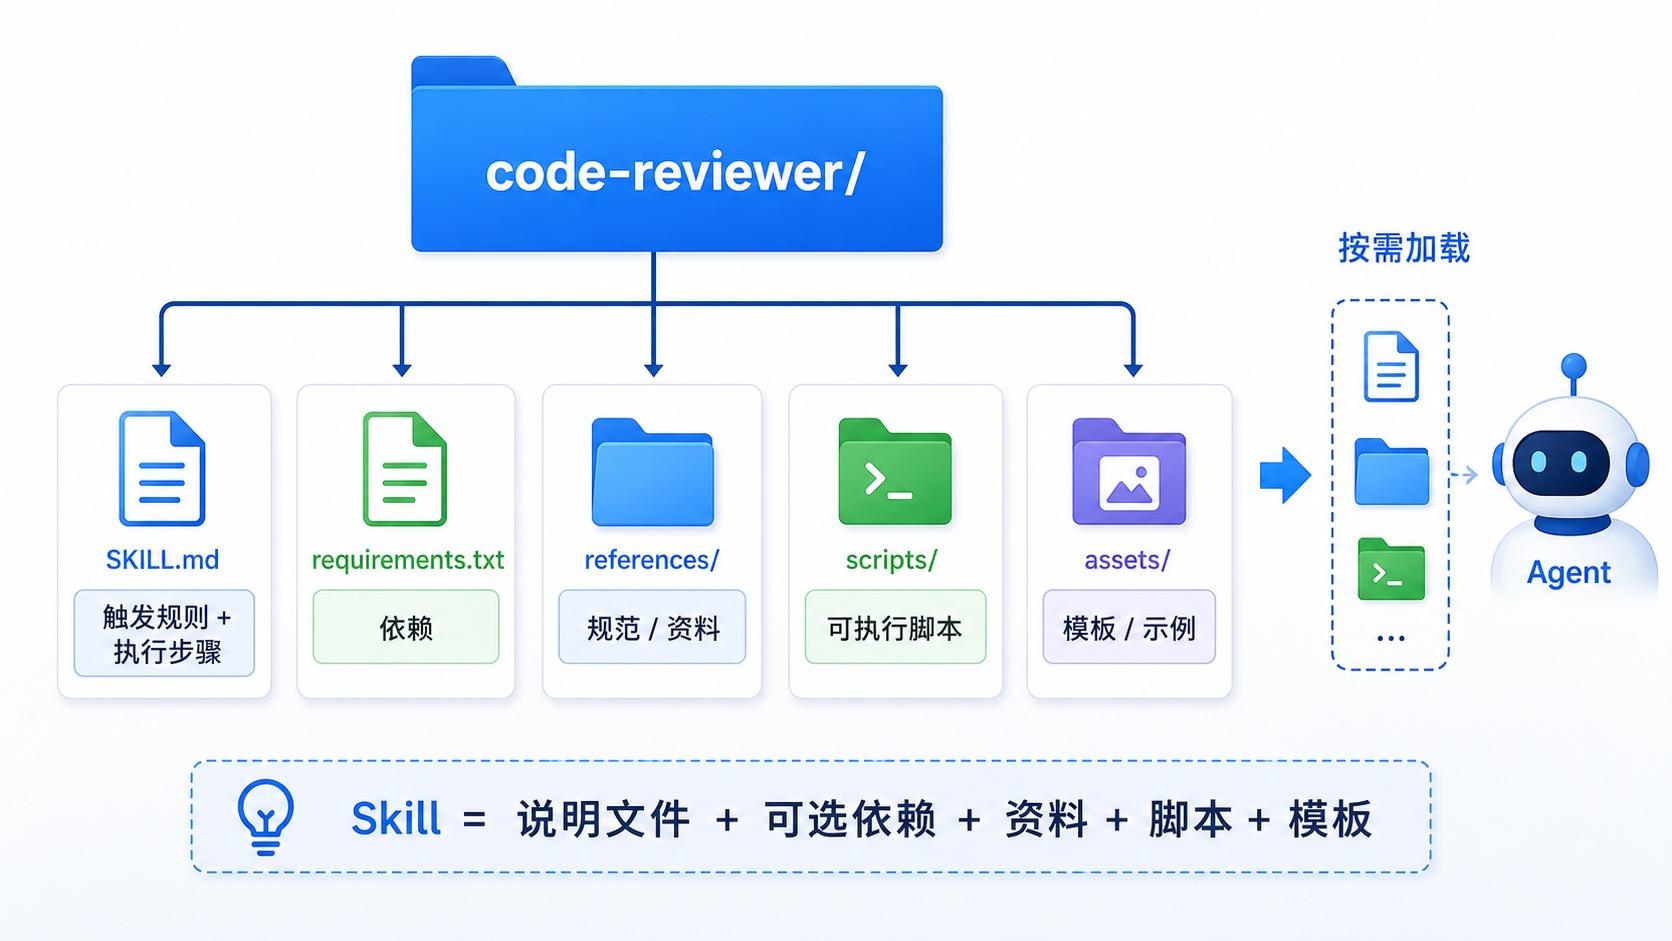
各目录职责如下:
| 路径 | 作用 |
|---|---|
SKILL.md |
技能说明、触发规则、执行步骤 |
requirements.txt |
这个技能需要的 Python 依赖 |
references/ |
技能需要参考的文档、规范和模板 |
scripts/ |
技能执行时可能调用的脚本 |
assets/ |
样例、图片、表格、素材文件 |
其中 references/ 可以继续按用途拆分:
| 子目录或文件 | 适合存放的内容 |
|---|---|
templates/ |
报告模板、代码模板、标准输出模板 |
examples/ |
输入输出样例,帮助 Agent 理解预期格式 |
config/ |
检查规则、字段映射、默认参数等配置文件 |
style-guide.md |
团队编码规范、写作规范、品牌规范 |
模型并不会凭空知道怎么用这些脚本和资源。需要在 SKILL.md 里写清楚:
当需要做静态检查时,运行 `scripts/run_static_check.py`。
当需要判断 Java 代码风格时,参考 `references/java-style-guide.md`。
最终输出格式参考 `assets/review-template.md`。
3.5 正文要写什么
SKILL.md 正文不要只写愿望,要写执行路径。
| 信息 | 要回答的问题 |
|---|---|
| 角色定位 | 这个 Skill 让 Agent 扮演什么专业角色 |
| 触发边界 | 什么时候用,什么时候不用 |
| 执行步骤 | 按什么顺序完成任务 |
| 资源引用 | 需要读哪些模板、规范、样例或脚本 |
| 输出格式 | 最终结果应该长什么样 |
4. 渐进式加载机制
4.1 按需加载
如果项目里有很多 Skill,每个 Skill 都有一大段说明、脚本介绍和资源引用,不可能一开始就全部塞进模型上下文。
这样会带来三个问题:
- 上下文窗口被快速撑爆。
- Token 成本增加。
- 模型面对太多技能时更难选择。
所以 Skill 通常采用 Progressive Disclosure(渐进式披露)。
4.2 三层加载
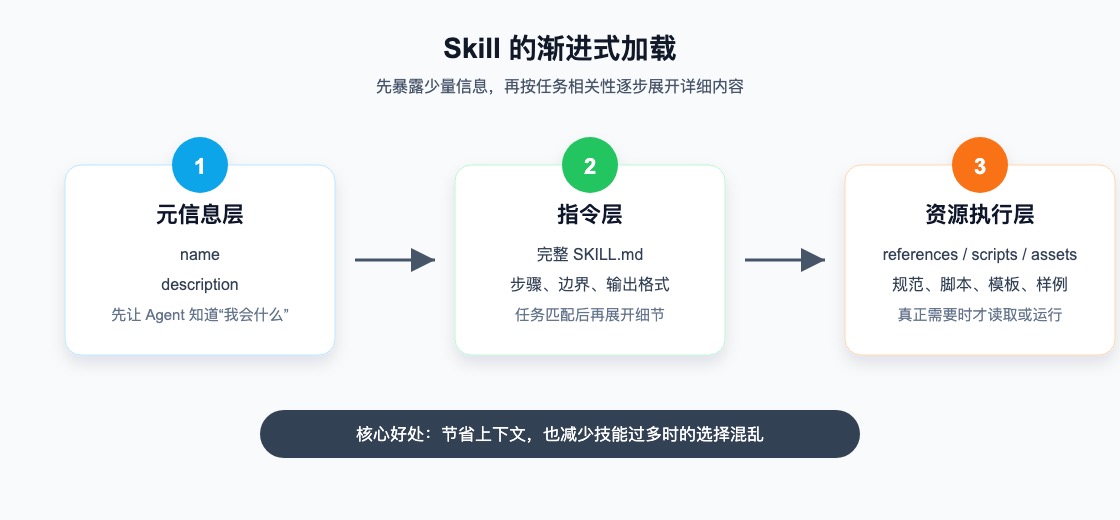
可以把加载过程理解为三层:
| 层级 | 加载内容 | 什么时候加载 |
|---|---|---|
| 元信息层 | name、description 等 Frontmatter |
Agent 启动或扫描 Skills 时 |
| 指令层 | 完整 SKILL.md 正文 |
模型判断当前任务需要这个 Skill 时 |
| 资源执行层 | references/、scripts/、assets/ |
只有任务真的需要时,才进一步读取或运行 |
加载顺序可以记成:先让模型知道“我会什么”,任务匹配后再展开“具体怎么做”,真正需要时才读取脚本、模板和资料。
4.3 description 是触发门牌
description 是 Skill 的“触发门牌”。
如果它写得太泛:
description: 用来处理文档。
模型很难判断:是 Word 文档、PDF 文档、Markdown 文档,还是技术文档?
更好的写法:
description: 当用户要求审查 Markdown 技术教程的结构、标题层级、代码块说明和读者理解难度时使用。
这类描述同时包含了:
- 任务对象:Markdown 技术教程;
- 任务动作:审查结构、标题、代码块说明;
- 触发条件:用户要求审查文档;
- 适用边界:不是所有文档都触发。
4.4 怎么测试触发是否稳定
写完 Skill 后,不要只看文件是否存在,更要测试它能不能在合适场景触发。
可以准备三类测试句:
| 测试句类型 | 目的 | 示例 |
|---|---|---|
| 明确触发 | 验证模型知道应该用这个 Skill | “请用代码审查技能审查这个 diff。” |
| 隐含触发 | 验证描述是否覆盖真实表达 | “帮我看看这个 PR 有没有安全和边界问题。” |
| 不应触发 | 验证边界是否清楚 | “解释一下这段代码在做什么。” |
如果明确触发都不稳定,通常是路径、元数据或工具配置问题。 如果隐含触发不稳定,通常是 description 写得不够贴近真实用户表达。 如果不应触发时频繁触发,通常是 description 写得太宽。
5. Skill 与其他能力的边界
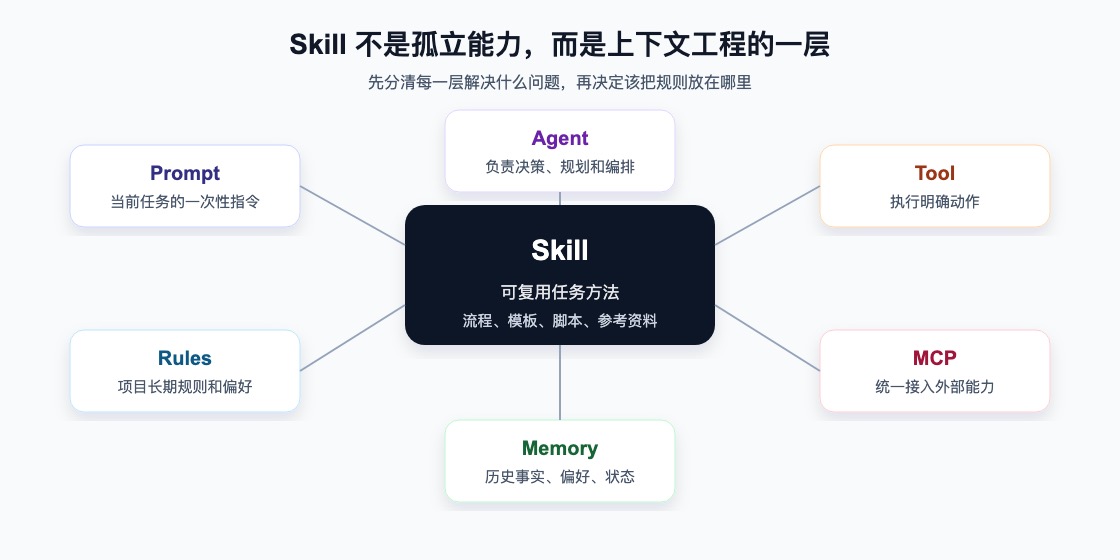
| 形式 | 适合放什么 | 典型例子 |
|---|---|---|
| Prompt | 当前任务的一次性要求 | “把这段文字改成更口语化” |
| Rules / AGENTS.md | 几乎每次都相关的项目规则 | “本项目用 pnpm”“API 返回结构统一” |
| Memory | 历史事实、用户偏好、长期状态 | “用户喜欢简洁回答”“这个项目已经迁到 FastAPI” |
| Skill | 特定任务才需要的流程、模板和资源 | “代码审查流程”“周报模板”“SQL 生成规范” |
| 形式 | 解决什么问题 | 一句话理解 |
|---|---|---|
| Tool | 执行一个明确动作 | “我能做什么动作” |
| MCP | 用统一协议接入外部工具和资源 | “外部能力怎么标准化接进来” |
| Skill | 封装任务方法、流程、规则和资源 | “遇到这类任务应该按什么方法做” |
6. 如何写一个高质量的 Skill
6.1 description
一个好的 description 最好同时回答四件事:
| 要点 | 示例 |
|---|---|
| 做什么 | 审查 Python / FastAPI 后端代码 |
| 什么时候用 | 当用户要求 code review、查找 bug 或安全风险时 |
| 处理什么输入 | diff、PR、文件路径、代码片段 |
| 不要太泛 | 不要写成“帮助写代码”这种所有场景都可能匹配的描述 |
推荐模板:
description: 当用户要求【任务动作】,并且输入是【输入类型】,目标是【预期结果】时使用。不要用于【排除场景】。
6.2 小而专
一个 Skill 最好只解决一类能力。
清晰的 Skill:
python-code-reviewerfastapi-api-debuggermarkdown-doc-editorsql-query-writerfrontend-accessibility-reviewer
6.3 脚本和资源要怎么放
适合放脚本的内容:
- 格式检查;
- 静态扫描;
- 数据清洗;
- 模板渲染;
- 依赖明确的转换逻辑;
- 可重复、可测试、确定性强的步骤。
不适合放脚本的内容:
- 需要大量主观判断的任务;
- 一次性临时操作;
- 依赖用户环境但没有说明的命令;
- 有高风险副作用的操作,比如删库、发邮件、扣款。
一个好经验是:
能稳定自动化的部分交给脚本;
需要理解、判断和表达的部分交给模型;
两者之间的流程写在 SKILL.md 里。
6.4 不要绕开安全边界
Skill 可以说明流程,但不要让 Skill 代替权限控制。
高风险动作包括:
- 删除文件;
- 删除数据库;
- 发送邮件;
- 调用支付接口;
- 修改生产配置;
- 执行不可逆脚本。
这些动作应该由工具权限、人工审批、中间件、沙箱和业务幂等设计来控制。Skill 只能写规则,不能代替安全边界。
6.5 命名和维护
团队里的 Skills 应该被当成工程资产:
- 名称稳定,尽量使用小写字母、数字和短横线;
- 放进版本控制;
- 写清维护人、版本和重要变更;
- 配套示例输入和示例输出;
- 定期删除过时 Skill;
- 对脚本做最小可行测试;
- 对外部依赖和权限做安全审查。
7. AI 编程工具里的 Skills 实践
不同 AI 编程工具对 Skills 的支持方式不完全一样。学习时不要只背目录名,要理解背后的三类能力:
| 能力类型 | 代表形式 | 解决的问题 |
|---|---|---|
| 技能包 | SKILL.md、skills/ 目录 |
按任务加载专业流程和资源 |
| 常驻规则 | .cursor/rules、AGENTS.md、项目说明 |
让 Agent 持续遵守项目约定 |
| 外部工具连接 | MCP、插件、Connectors | 让 Agent 访问外部系统和动作 |
8. 什么时候应该写 Skill
适合使用 Skill 的场景:
- 一套提示词会被多个 Agent 或多次任务复用;
- 某个任务有固定步骤和输出格式;
- 某项能力需要附带脚本、模板或参考资料;
- 希望把“能力说明”从主提示词里拆出来;
- 希望减少主 Agent 的 system prompt 长度;
- 团队有一套希望复用的标准流程;
- 某类任务需要按需加载大量上下文,而不是每次都塞进 Prompt。
典型例子:
| Skill 名称 | 适合封装的内容 |
|---|---|
code-reviewer |
审查维度、严重级别、输出格式、测试缺口判断 |
markdown-doc-editor |
文档结构、标题层级、代码块说明、读者视角 |
frontend-accessibility-reviewer |
可访问性、键盘操作、语义标签、视觉层级 |
sql-query-writer |
表结构说明、查询规范、性能注意事项 |
incident-postmortem-writer |
故障复盘模板、时间线、影响范围、改进项 |
不适合使用 Skill 的场景:
- 只是一次性的小提示;
- 任务非常简单,不值得单独封装;
- 触发条件很模糊,模型难以判断什么时候用;
- 多个 Skill 描述重叠,容易抢同一个任务;
- 内容几乎每次都要加载,更适合放 Rules 或项目说明;
- 本质是外部动作,更适合做 Tool 或 MCP;
- 需要独立上下文和职责隔离,更适合做 Subagent。
这个能力会重复用吗?
它有明确触发条件吗?
它有固定步骤或输出格式吗?
它需要附带模板、资料或脚本吗?
它不适合每次都放进主提示词吗?