grill-me
学习笔记
skill
这个是我最喜欢用的一个 Skill ,能帮我想清楚我到底要做什么,或者是不去做什么
grill-me 是一个让 AI 反过来面试你的 Skill。 但它本身极其简单——整个文件只有 1 行代码:
grill-me 是一个入口,真正干活的是 grilling 这个 skill。
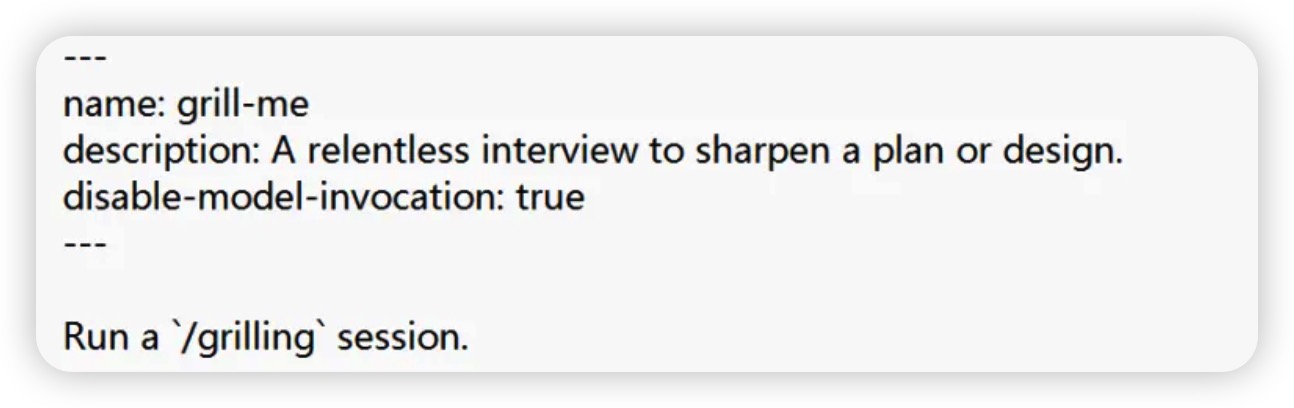
这个设计极其聪明——grill-me 标记为 disable-model-invocation: true,只有你主动调用时才触发,不会占用 AI 的上下文窗口。而 grilling 是 model-invoked,可以被其他 Skill 复用。
所以下文提到”追问逻辑”的时候,说的都是 grilling 引擎,不是 grill-me 本身。记住这个区分,整个设计哲学你就能看懂。
grilling 引擎
grilling 引擎做了什么? 在写代码之前,AI 会像审讯官一样,沿着你计划中的每一个决策分支,一次一个问题地追问——直到你们两个对”到底要做什么”达成完全一致。
不是 AI 帮你做决定。是 AI 让你意识到哪些决定还没做。
它解决的是 AI 编程的第一失败模式:Agent 没做你想要的——因为你要什么,连你自己都没想清楚。
现在最新的 v1.2 版本,改为按照轮次进行提问,原来的一个一个问,太慢了,容易让人烦。 现在就是一批一批的问
三个核心特征:
- 一次只问一个问题——反对批量提问。Matt 的原话是”一次问多个问题会让人困惑(bewildering)”
- 每个问题附带推荐答案——降低你的决策疲劳。你只需要说 Yes / No / It depends
- 能从代码库查到的,不问你——只有真正需要你做取舍的决策,才会端到你面前
典型的 grilling session:15-50 个问题,30-60 分钟。少于 5 个说明需求写太细了(不需要 grill),大于 50 个说明范围太大需要拆分。
3 个层次
Level 1:/grill-me — 纯对话版
适用场景:没有代码库,纯聊天打磨想法。
怎么用:在任何 Claude Code 会话里输入:
每一个问题都带推荐答案,你只需要点头或摇头。 6 个问题、2 分钟,所有模糊点变成了明确的技术决策。
这个层面你只需要记住一句话:/grill-me 是对话工具,不碰文件,不产生代码。追问结束后的产出——全在你的脑子里和聊天记录里。
/grill-with-docs — 代码库版 + 自动沉淀
适用场景:有代码库,需要把追问结论固化到项目文档中。
核心区别:在 grilling 引擎的基础上,同步运行 /domain-modeling:
| 产出的文档 | 作用 | 写什么 |
|---|---|---|
CONTEXT.md |
项目术语表 | 所有领域术语的精确定义 |
| ADR(架构决策记录) | 硬决策归档 | 只记录同时满足三个条件的决策 |
ADR 的三个条件:不可逆 + 脱离上下文会困惑 + 确实做了取舍。
不满足这三个条件的决策,不写 ADR。Matt 自己的项目里,ADR 目录通常不超过 10 个文件。
Level 2 的关键认知:grill-with-docs 解决的不仅是”这次把需求说清楚”,更是”下次换一个会话 / 换一个人,不需要重新说清楚”。共享语言(CONTEXT.md)让每一次 AI 会话都变得更短、更精准。
Level 3:grilling 引擎 + 你写的 Skills
适用场景:你自己写 Skill,想复用追问机制。
怎么用:在你的 SKILL.md 里,不需要重写追问逻辑。直接引用 grilling 引擎:
# 在你自己写的 Skill 里:
  执行以下步骤:
  1. 运行 /grilling session,确认用户需求和技术边界。
 2. 追问结束后,进入实现阶段……
因为 grilling 是 model-invoked,你的 Skill 可以直接调用它,不用复制粘贴。这就是 Matt 架构里最聪明的地方:把追问能力做成一个可复用的组件。
你需要理解的是 grilling 引擎的设计原则(下一章),这样你才知道什么时候该调用它、什么时候该自己写追问逻辑。
完整源码
---
name: grilling
description: Grill the user relentlessly about a plan, decision, or idea. Use when the user wants to stress-test their thinking, or uses any 'grill' trigger phrases.
---

Interview the user relentlessly until you reach a shared understanding. Map this as a **design tree**: every decision branches into the decisions that hang off it.

Work the tree in **rounds**. The **frontier** is every decision whose prerequisites are already settled — the questions you can ask _now_ without guessing at answers you haven't heard yet. Ask the whole frontier in one round: number each question and give your recommended answer. Then wait for the user's answers before the next round.

Each question should be formatted like so:

```
❓ **Q1** - **<question title>**: <question body, might be multiple paragraphs, including multiple choices>

➡️ <your recommended answer>
```

Each round the user answers reshapes the tree — settled decisions push the frontier outward and unblock questions that depended on them. Recompute the frontier and ask the next round. A question whose answer depends on another question still open in this round belongs to a _later_ round, not this one.

Finding _facts_ is your job, never the user's. When a frontier question needs a fact from the environment (filesystem, tools, etc.), dispatch a sub-agent to find it — don't ask the user for anything you could look up yourself. Don't block on it: a running exploration is an unsettled prerequisite, so only the questions downstream of it wait for the sub-agent to report — ask the rest of the frontier now. The _decisions_ are the user's — put each to them and wait.

The session is done when the frontier is empty: every branch of the design tree visited, nothing left silently assumed. Do not act on it until the user confirms you have reached a shared understanding.
---

name: grilling
description: 针对计划、决策或想法对用户进行持续而深入的追问。当用户希
望压力测试其思路,或使用任何“grill”触发短语时启用。

---

持续追问用户,直到双方达成共同理解。将其映射为一棵**设计决策树**:每个
决策都分支出与之相关的下游决策。

按**轮次**推进。**前沿问题**是指所有前置条件已经确定的决策——也就是当前
无需猜测用户尚未回答内容即可提出的问题。在每一轮中,一次性提出全部前沿问
题:为每个问题编号,并给出你的建议答案。然后等待用户回答,再进入下一轮。

每个问题应采用以下格式:

```text
❓ **Q1** - **<问题标题>**:<问题正文,可以包含多段文字和多个选项>

➡️ <你的建议答案>
```

用户每轮的回答都会重新塑造决策树——已经确定的决策会将前沿向外推进,并解除
依赖它们的问题。重新计算前沿,然后提出下一轮问题。如果某个问题的答案依赖
于本轮中另一个尚未解决的问题,那么它应放到后续轮次,而不是本轮提出。

查找事实是你的职责,不要让用户代为查找。当某个前沿问题需要依赖环境事实(
文件系统、工具等)时,应派遣子智能体去查找,而不是询问用户任何你可以自行
获取的信息。不要因此阻塞流程:正在进行的探索属于尚未解决的前置条件,因此
只有依赖该探索结果的下游问题需要等待;其余前沿问题应立即提出。决策由用户
做出——将每个决策交给用户,然后等待其回答。

当所有前沿问题都已解决时,会话结束:设计树的每个分支都已访问,不再存在任
何未明确说明的假设。在用户确认双方已经达成共同理解之前,不要采取行动。
第一块:定义任务 + 完成标准
Interview me relentlessly about every aspect of this plan until we reach a shared understanding.
“relentlessly” 是整个文件最重要的词。它不是 “carefully”(仔细地)、不是 “thoroughly”(彻底地)、不是 “comprehensively”(全面地)——这三个词在 LLM 的默认行为里全是 no-op(不改变行为的废话)。
“Relentlessly” 告诉模型:这次的追问比平常的”彻底”更猛,不要因为觉得够了就停。 一个词完成了 20 行指令才能达到的行为锚定。
“until we reach a shared understanding” 是完成标准(completion criterion)。它必须是可检查的——模型自己能判断”理解了”还是”还没理解”。好的完成标准不需要人类介入验证。
第二块:决策树遍历算法
Walk down each branch of the design tree, resolving dependencies between decisions one-by-one. For each question, provide your recommended answer.
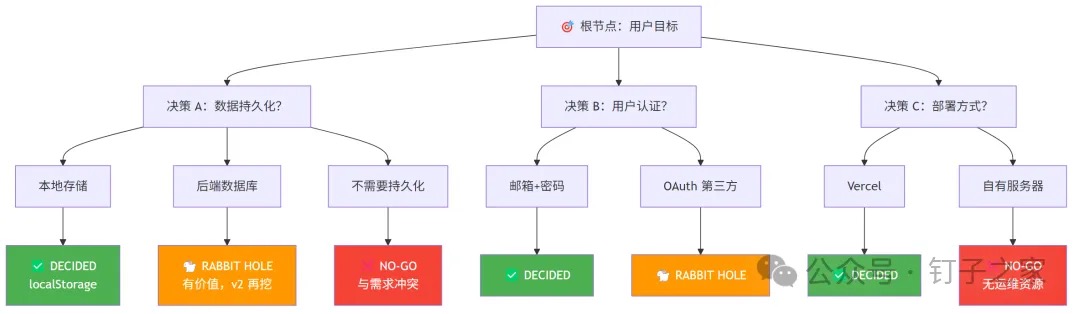
“design tree” 来自 Frederick Brooks 的经典著作《The Design of Design》。LLM 的预训练数据里有这个概念的完整知识——设计是一个树形结构,每个节点是一个决策,每个分支是一个选择。
这一行包含了一个隐式的遍历算法:
- 从根节点(最高层目标)开始
- 沿一个分支走到底
- 回溯,走下一个未遍历的分支
- 重复直到所有分支都被访问
每个分支的终点是三种状态之一:
- DECIDED(已决定)——可以走
- RABBIT HOLE(兔子洞)——有价值但现在不挖,标记后跳出
- NO-GO(不可行)——死路,排除后跳出
第三块:反批量提问
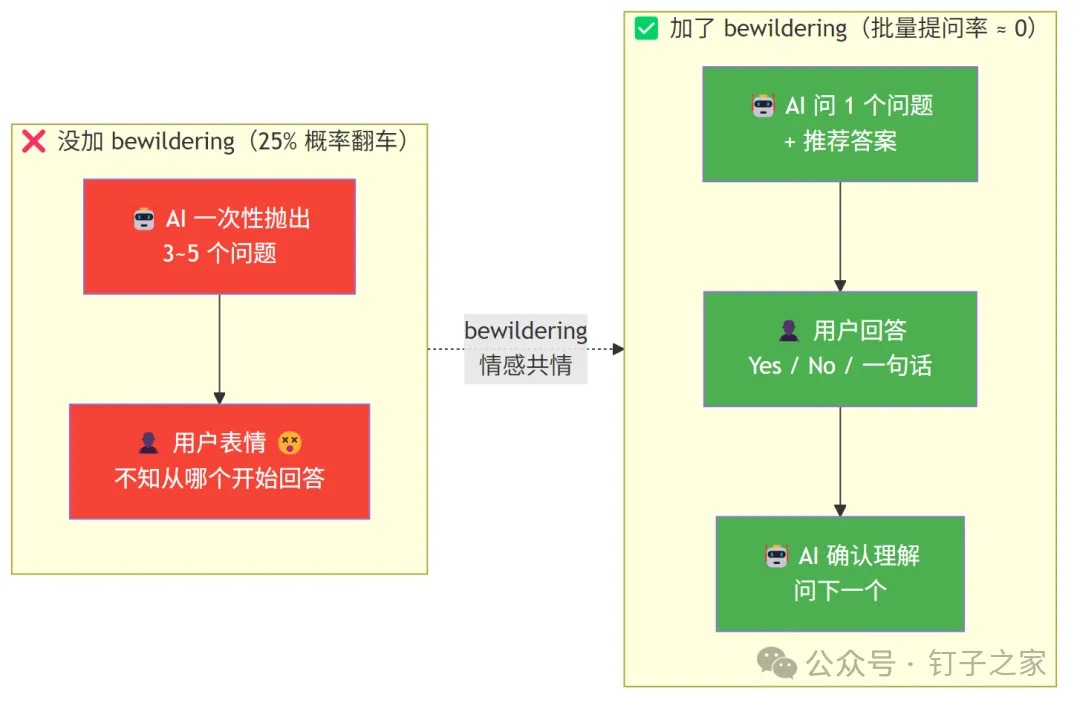
Ask the questions one at a time, waiting for feedback on each question before continuing. Asking multiple questions at once is bewildering.
这一行是 v2 版本加的。Matt 观察到,不加这一行時,模型在约 25% 的会话中会一次性抛出 3-5 个问题。
加了 “bewildering” 之后,批量提问率降到接近零。
为什么是 “bewildering” 而不是 “bad practice” 或 “forbidden”?
因为 LLM 对 “bewildering” 有情感共情——它在训练数据里见过无数人类描述被信息轰炸時的困惑感。”Bad practice” 只是一条规则,LLM 会在边界条件测试中自我合理化地违反它。”Bewildering” 让 LLM 理解了人类感受——它不是在违反规则,是在让人困惑。
这是一个单一词汇改变行为模式的经典案例。
第四块:事实 vs 决策
If a question can be answered by exploring the codebase, explore the codebase instead.
全文件最重要的 6 个英文单词。这行解决的是 LLM 的天然缺陷:分不清”能从代码库查到的事实”和”需要人类做决定的取舍”。
这也是 v1.1.0 的 bug fix。之前某些 workflow 里,Agent 会替用户回答决策问题——把”我猜你想用 PostgreSQL”当成事实写进代码。
现在它被训成了:先用工具读代码,读到答案就闭嘴;读不到才开口问。
设计哲学:Matt Pocock 的 Skill 写作方法论
理解 grilling 的源码只是第一步。理解它背后的设计哲学,你才能在自己的项目里做出同等质量的 Skill。
这套哲学来自 Matt 的 /writing-great-skills 元技能(83 行 + 配套 GLOSSARY.md)。以下五个概念是核心。
1. Leading Words(引导词)
Leading Word = 一个在模型预训练数据中已经深度理解的紧凑概念。不需要重新教,只需要激活。
| 在 grilling 中出现 | 模型已有的知识 | 省掉了多少行指令 |
|---|---|---|
| grill | 审讯式追问、单刀直入、不给面子 | ~15 行 |
| relentlessly | 不达目的不停手 | ~20 行 |
| design tree | 树形结构、分支遍历、叶子节点 | ~25 行 |
| bewildering | 人类被信息轰炸的困惑感 | ~10 行 |
对比 Superpowers 的 689 行:不是 Matt 偷懒,是两种哲学。Superpowers 假设模型会找一切机会逃逸,所以堵死每一个路径。Matt 假设模型已经懂得大部分概念,你只需要用 Leading Words 激活它们,然后用精确定位的行为约束(不是堵逃逸,是给正确方向)来校准。
2. Progressive Disclosure(渐进披露)
Skill 的内容不应该全部堆在一个文件里。应该按”模型需要它的紧急程度”分层:
Layer 1: SKILL.md 主体(~50 行以内)
   ↓ 每一步有明确的 completion criterion
  Layer 2: 同目录下的 references/ 文件
   ↓ 用 context pointer 引用
  Layer 3: 外部文件(代码库、文档、网站)
   ↓ 只在必须时才加载
grilling 做到了极致:引擎 7 行在 Layer 1,调用它的 Logic(triage、grill-with-docs 的追问策略)在各自的调用层,文档产出逻辑(domain-modeling)在 Layer 2。
3. Negation Discipline(否定纪律)
否定式指令会适得其反。”别想大象”就是在脑子里画大象。
grilling 全文没有一个 “don’t”。看它如何避坑:
| 坏写法(否定式) | grilling 的实际写法(正向 + 解释) |
|---|---|
| Don’t ask multiple questions at once. | Ask the questions one at a time. |
| Don’t overwhelm the user. | Asking multiple questions at once is bewildering. |
| Don’t answer your own questions. | If a question can be answered by exploring the codebase, explore the codebase instead. |
第三条是最漂亮的——它不是禁止 LLM 自问自答,而是给它一个更正确的替代行为。LLM 不需要压抑冲动,它只需要走另一条路。
4. Completion Criterion(完成标准)
每个 Skill 的每一步都需要一个模型自己能检查的完成标准。
grilling 的完成标准设计得很精妙:
- “until we reach a shared understanding” ——模型能自检(用户说”对”、”明白了”、”可以了”)
- “each branch of the design tree” ——树遍历的隐喻自带检测(所有分支都访问了 → 完成)
差的完成标准:”把需求想清楚”——什么叫清楚?模型不知道。
好的完成标准:”设计树的每个分支都被标记为 DECIDED / RABBIT HOLE / NO-GO 之一”——模型能数出来还剩几个分支没走。
5. Sediment(沉积物)与 Deletion Test
Sediment = 随着时间推移堆积在 Skill 文件里的无效指令。多人协作修改、版本迭代、补丁叠加——慢慢地,文件里塞满了”写了但没用”的东西。
Deletion Test:删掉一行 → 跑一轮 → 看行为变了没。没变 → 这一行是 sediment → 永久删除。
Superpowers 的 writing-skills 有 689 行。做了 deletion test 能剩下多少?不知道——但是如果 689 行里有 200 行是沉积物,那这 200 行除了吃掉上下文 token 之外毫无作用。
grilling 的 12 行里,每一行都通过过 deletion test。
实践
Matt 在 aihero.dev 上发过一个视频《9 Things People Get Wrong With My /grill-* Skills》。以下是精华浓缩版:
| # | 错误 | 后果 | 正确做法 |
|---|---|---|---|
| 1 | 混淆低保真和高保真问题 | 争论表单布局 10 分钟没结论 | “这个表单应该两栏还是三栏?”→ 切 /prototype 做个原型,30 秒就有答案 |
| 2 | 范围太大 | 50+ 个问题还没停,上下文爆炸 | 让 AI 帮你拆成小块,分 session 追问 |
| 3 | 太被动 | 被 AI 带着跑了 45 分钟,很多问题显然可以跳过 | 主动说”这个方向正确,直接推进到下一层” |
| 6 | 用弱模型做 grilling | AI 提的问题全是虚的(”你希望什么风格?”) | Grilling 用前沿模型(Opus/Sonnet,高推理 effort);写代码可以用弱模型 |
| 7 | 不跑并行 session | 大项目追完整棵决策树要 2 小时 | 拆成多个聚焦的 grilling session,两个窗口并行跑 |
| 8 | 把能从代码库查到的反过来问你 | AI 问”现在用的是什么数据库?” | 明确指令:能从代码库查的不问我(这是 grilling 引擎内置的) |
| 9 | 跳过 grilling 直接 Plan Mode | AI 产出看起来很专业但核心假设全错的方案 | 永远先 grill 对齐 → 再 plan → 再执行 |
low vs high fidelity questions
fidelity 本来的意思是保真度 / 忠实程度 / 细节程度。 low fidelity questions 和 high fidelity questions 可以理解成:问题对背景、约束和期望结果描述得有多具体。
Low fidelity = 模糊、开放、信息少的问题 High fidelity = 具体、明确、约束充分的问题
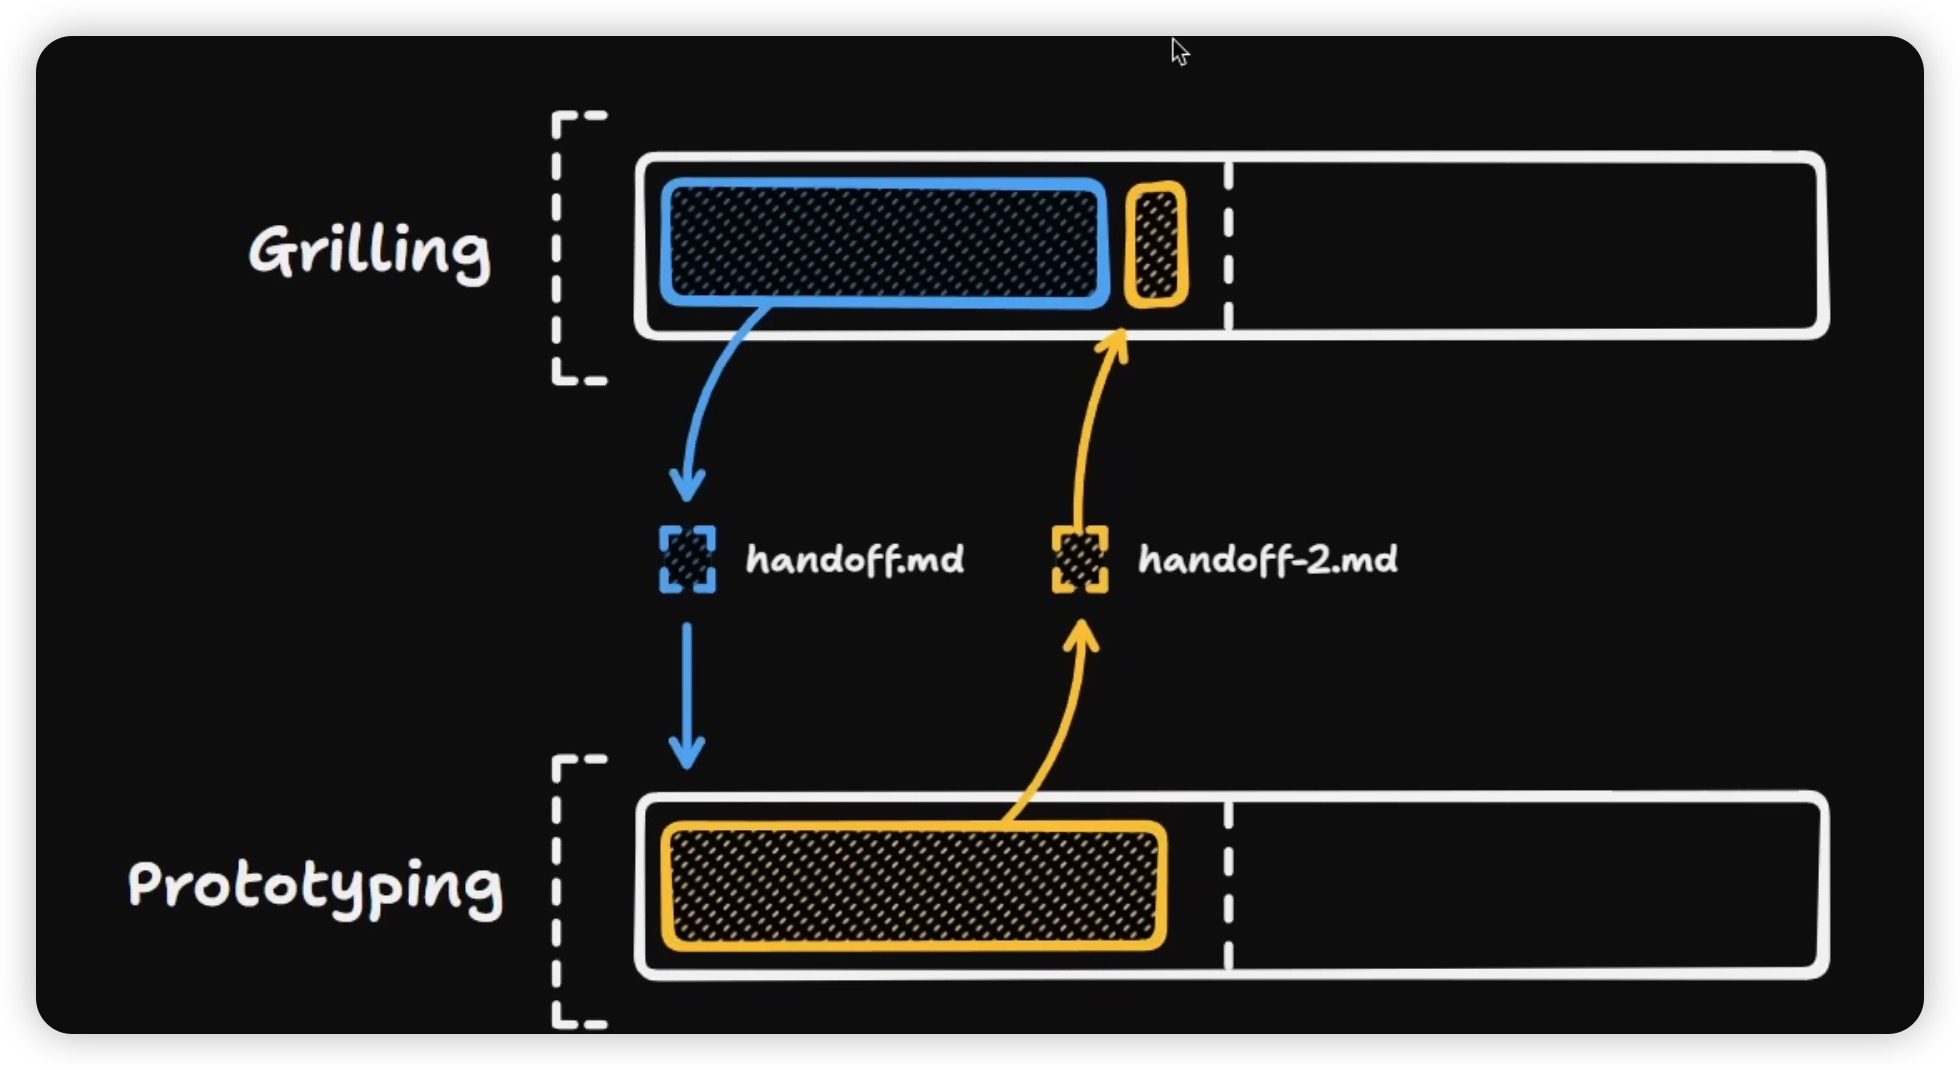
高保真的问题,比如 UI,感受等,可以使用 handoff 总结当前的内容,然后使用 prototy 这个 skill,制作一个原型,进行查看,然后再次使用 handoff 回到之前的对话。
Managing scope correctly
注意提问的范围
拆分,然后逐个进行 grill
Being active not passive
主动参与,不要被 AI 的提问牵着走,我之前就遇到过这样的情况,一直都问我一些细节,感觉没有必要的问题,需要自己去主导提问的走势。
Preserving grilling session value
及时的保留提问之后的内容,使用 to-spec 形成文档。
Useing smart models for grilling
用聪明的模型来进行 grill
Running parallel grilling sessions
并行同时开几个会话,来进行 grill
实战,什么时候该用
✅ 应该用 grilling 的场景
- 复杂改动、多分支决策、意图模糊
- 跨模块重构、数据模型或 API 形态修改
- 涉及大量领域术语
- 做错后的返工成本高
- 后续其他 Agent 要继续同个计划
❌ 不应该用的场景
- 改一行配置、修一个明确 bug
- 你能用一句话写清楚:目标 + 范围 + 禁止事项 + 验收标准
- 单文件内的改动
判断标准:你能在一句话里写清楚「要什么 + 不要什么 + 怎么算做完」,就不必 grill。写不出来——先别让 AI 动代码。
| 阶段 | 推荐 | 说明 |
|---|---|---|
| 大项目(方向不明确) | /wayfinder |
先画地图,再启动并行 grilling |
| 改小东西 | 不开 grill | 直接写代码 |